Agentic RAG w n8n: dlaczego klasyczny RAG często zawodzi – i jak zrobić to lepiej
Klasyczny RAG często pomija kontekst i dane tabelaryczne. Jak konfiguracja Agentic RAG w n8n przeszukuje bazy wiedzy pewniej – wyjaśnione praktycznie.
Wiele firm stawia dziś na asystentów AI, którzy mają odpowiadać na pytania o własne dokumenty – protokoły ze spotkań, tabele ze wskaźnikami czy opinie klientów. Powszechnie stosowana metoda nazywa się Retrieval Augmented Generation (RAG). Jest rozpowszechniona, dobrze wspierana i szybka do wdrożenia w narzędziach no-code takich jak n8n. Tyle że w praktyce klasyczny RAG zaskakująco często zwraca błędne lub niepełne odpowiedzi. Cole Medin pokazuje w swoim filmie, z czego to wynika i jak tak zwana konfiguracja Agentic RAG omija typowe słabości. Podsumowuję trzeźwo najważniejsze punkty.
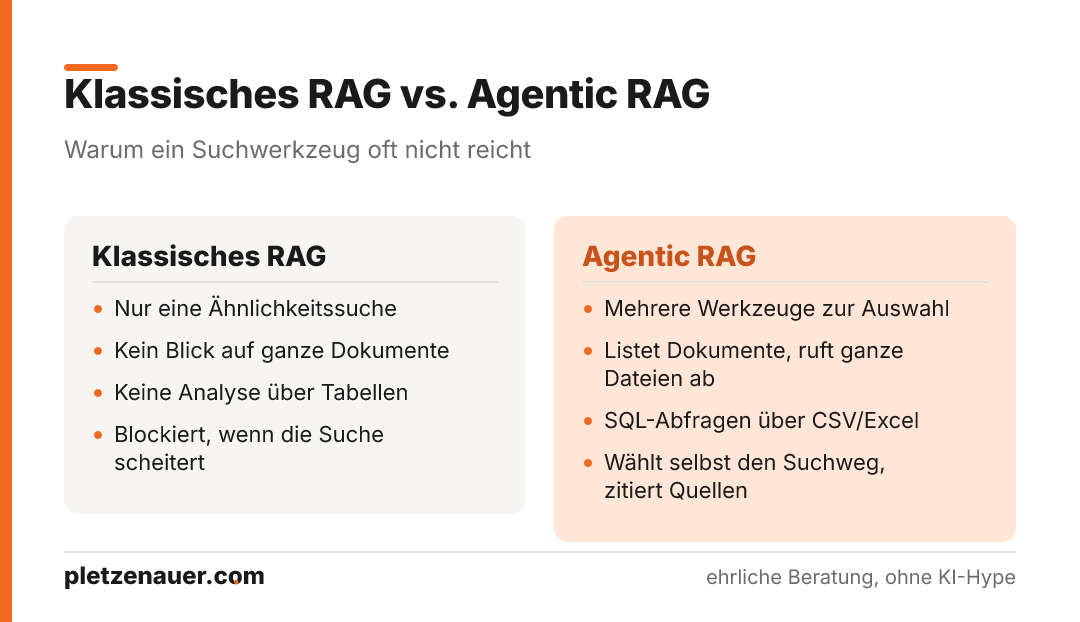
- Klasyczny RAG zawodzi przede wszystkim z dwóch powodów: nie potrafi “oddalić widoku” na całe dokumenty ani przeprowadzić prawdziwej analizy danych na tabelach.
- Agentic RAG daje agentowi AI kilka narzędzi zamiast jednego wyszukiwania – sam decyduje, jak przeszukuje bazę wiedzy.
- Tabele (CSV/Excel) są zapisywane osobno, dzięki czemu można je odpytywać przez SQL – bez zakładania osobnej tabeli dla każdego pliku.
- Agent potrafi wylistować dokumenty, pobrać całe pliki, cytować źródła i w razie potrzeby poprawić zapytanie.
- Pokazana konfiguracja n8n to rozszerzalny szablon, a nie gotowy produkt – prompty i narzędzia trzeba dostosować do własnego przypadku użycia.
Dlaczego klasyczny RAG rozczarowuje w praktyce
RAG działa przez wyszukiwanie podobieństwa: zapytanie jest porównywane z zapisanymi fragmentami tekstu (“chunkami”), a najlepiej pasujące trafiają do modelu językowego. Problemem jest ten wybór. Regularnie pomija istotny kontekst.
Medin wymienia dwie konkretne słabości:
- Brak spojrzenia na całe dokumenty: RAG sięga tylko po pojedyncze wycinki. Kto chce analizować trendy w tabeli, dostanie może ćwierć wierszy – a wraz z tym błędny wynik.
- Brak prawdziwej analizy danych: sum ani wartości maksymalnych z tabeli nie da się wiarygodnie policzyć samym wyszukiwaniem tekstowym.
Do tego dochodzi praktyczna uciążliwość: gdy pyta się o protokół z określonej daty, RAG bywa, że wyciąga dokument z niewłaściwego dnia – mimo że data jest w tytule. A łączenie różnych dokumentów w szerszy kontekst udaje się rzadko.
Co Agentic RAG robi inaczej
Główna myśl jest prosta: zamiast dawać agentowi AI jedno jedyne narzędzie wyszukiwania, dostaje ich kilka – i sam może decydować, jak sięga do bazy wiedzy. Medin definiuje Agentic RAG tak:
Agentic RAG oznacza danie agentowi zdolności do zastanowienia się nad tym, jak przeszukuje bazę wiedzy – zamiast przypisywać go na sztywno do jednego narzędzia.
Konkretnie: agent może dzięki temu poprawiać zapytania, w razie potrzeby wybrać inne narzędzie i wypróbować kilka dróg, aż uzyska wiarygodną odpowiedź. Gdy samo wyszukiwanie RAG zawiedzie, nie jest już zablokowany.
Cztery narzędzia agenta
W workflow n8n agent ma do dyspozycji następujące narzędzia:
- Wyszukiwanie RAG – klasyczne wyszukiwanie podobieństwa, w ulepszonej wersji wraz z podaniem źródła.
- Listowanie dokumentów – agent pobiera wszystkie dokumenty wraz z tytułami i identyfikatorami i zastanawia się, które mogą być istotne.
- Pobranie treści pliku – po identyfikatorze pliku pobiera pełny tekst konkretnego dokumentu (na przykład protokół z 23 lutego, rozpoznawalny po tytule).
- Zapytanie SQL na tabelach – pliki CSV i Excel są odpytywane jak tabele SQL, aby umożliwić sumy, maksima i podobne analizy.
W system promptcie agent dostaje instrukcję, by zaczynać od RAG i sięgać po pozostałe narzędzia tylko wtedy, gdy wyszukiwanie nie zwraca właściwych treści. Ważna wskazówka z filmu: wyraźne wezwanie agenta do uczciwości – czyli do otwartego przyznania, że nie znalazł odpowiedzi – odczuwalnie redukuje halucynacje.
Jak zapisywane są dane tabelaryczne
Technicznie najciekawsza część dotyczy tabel. W Supabase zakłada się w tym celu trzy tabele:
- documents – zawiera embeddings dla RAG, metadane i treść poszczególnych chunków.
- document_metadata – przechowuje informacje nadrzędne: tytuły, adresy URL do podania źródeł oraz – przy tabelach – schemat (czyli nazwy kolumn).
- document_rows – odkłada wiersze tabeli. Właściwe dane lądują w elastycznej kolumnie JSONB o nazwie
row_data.
Sztuczka: przez JSONB można zapisać dowolne struktury kolumn, bez konieczności tworzenia osobnej tabeli SQL dla każdego pliku CSV czy Excel. Agent najpierw odczytuje schemat z metadanych, rozumie dostępne kolumny i dopiero potem formułuje zapytanie SQL na row_data. Medin wyraźnie zaznacza, że ta konfiguracja jest uproszczona – schemat nie mówi na przykład nic o typach danych, więc suma po kolumnie ze znakiem dolara może się nie udać. Chodzi mu o koncepcję, nie o perfekcyjne wdrożenie.
Pipeline RAG: z Google Drive do Supabase
Zanim agent może pracować, bazę wiedzy trzeba wypełnić. Pipeline przebiega przy tym w kilku krokach:
- Wyzwalacz: wyzwalacz Google Drive co minutę sprawdza nowe lub zmienione pliki. Alternatywnie działa Dropbox albo lokalny wyzwalacz plikowy. Usunięte pliki nie są jednak wykrywane.
- Kilka plików naraz: nowo wbudowana pętla przetwarza teraz także kilka plików, które trafiają w tym samym interwale odpytywania – znana wada poprzedniej wersji.
- Usuwanie starych danych: przed każdym importem usuwane są istniejące wpisy dla danego identyfikatora pliku. Dzięki temu nie zostaje żaden nieaktualny chunk, gdy dokument się skrócił.
- Ekstrakcja treści: węzeł Switch rozgałęzia się zależnie od typu pliku – PDF, Google Doc, tekst czy tabela są odczytywane inaczej. Kolejne formaty jak JSON czy HTML można dodać przez dodatkowe węzły.
- Podwójne zapisywanie tabel: pliki CSV są z jednej strony przygotowywane jako dokument tekstowy dla RAG, z drugiej zapisywane wierszami w
document_rowsna potrzeby zapytań SQL.
Praktyczna pułapka przy konfiguracji: do połączenia Postgres z Supabase trzeba według filmu użyć transaction poolera (port 6543), a nie połączenia bezpośredniego. Dokumentacja n8n ma być w tym miejscu niejasna.
Zastosowane modele
Do embeddingów używany jest text-embedding-3 od OpenAI, jako model językowy GPT-4o mini – świadomie wybrany jako tani i szybki. Do bardziej wymagających przypadków Medin poleca mocniejsze modele, jak GPT-4o czy Claude Sonnet 4. Ważne: przy wstawianiu i przy pobieraniu trzeba używać tego samego modelu embeddingów o tej samej liczbie wymiarów.
Trzy przykłady z filmu
Medin pokazuje, jak agent zależnie od pytania wybiera różne narzędzia:
- Pytanie o tabelę: na “w którym miesiącu mieliśmy najwięcej nowych klientów?” agent pisze zapytanie SQL i podaje poprawny wynik (grudzień, 129 nowych klientów) – zamiast polegać na niepełnych chunkach.
- Czyste pytanie RAG: na “gdzie możemy być lepsi?” wyszukiwanie podobieństwa znajduje dokument z opiniami, mimo że świadomie nie użyto słowa “poprawa”.
- Pobranie pliku ze źródłem: przy pobraniu kompletnego protokołu ze spotkania agent podaje action items, a na dopytanie klikalny link do źródła.
Wniosek
Wpis pokazuje trzeźwo, dlaczego naiwny RAG nie wystarcza w wielu zastosowaniach biznesowych: pomija kontekst i nie potrafi liczyć na tabelach. Podejście agentowe rozwiązuje to pragmatycznie, dając agentowi AI kilka narzędzi i pole decyzji. Dla decydentów w MŚP, którzy rozważają asystenta do dokumentów, to ważny wniosek: jakość nie stoi i nie upada wraz z samym modelem, lecz wraz z architekturą za nim. Kto przejmuje przedstawioną konfigurację n8n, powinien traktować ją jako punkt wyjścia – prompty, narzędzia i model danych należy dostosować do własnego zasobu danych. Zwłaszcza zapytania SQL na tabelach i obsługa typów danych zostawiają miejsce na ulepszenia.
Źródło: Cole Medin – „I Built the ULTIMATE n8n RAG AI Agent Template”, https://www.youtube.com/watch?v=mQt1hOjBH9o
Newsletter
Praxiswissen per E-Mail.
Neue Artikel und Erfahrungen aus Projekten mit Claude, WordPress und Zoho. Kein Spam, Abmeldung jederzeit.
Fast geschafft.
Bitte bestätigen Sie die Anmeldung über den Link in der Mail, die gerade unterwegs ist.
Porozmawiajmy
Czy to brzmi jak Państwa sytuacja?
Proszę krótko opowiedzieć, nad czym Państwo pracują. Powiem, czy i jak mogę pomóc. Rozmowa jest bezpłatna.