Agente RAG sem código: combinar n8n e Supabase de forma produtiva
Como construir com n8n e Supabase um agente de IA RAG pronto para produção, sem código: base de conhecimento, pesquisa vetorial e atualização automática de documentos explicadas.
A maior parte dos tutoriais de RAG na internet mostra sempre o mesmo brinquedo: «converse com o seu PDF». O que raramente se refere é que estas demonstrações estão muito longe de uma utilização produtiva. Assim que a base de conhecimento cresce, que os documentos são atualizados ou que os utilizadores fazem perguntas que ninguém testou, começam os problemas. É exatamente aqui que entra a abordagem descrita a seguir.
No seu vídeo, Cole Medin mostra como construir com as duas ferramentas n8n (automatização de fluxos de trabalho, comparável ao Make.com ou ao Zapier) e Supabase (plataforma de base de dados com suporte vetorial através de PG Vector) um agente de IA RAG mais próximo da prática do que muitos outros guias. A promessa: nenhum código, esforço controlável e uma montagem que cresce com a base de conhecimento. Para quem decide numa PME isto é interessante sobretudo porque permite tornar pesquisáveis documentos internos, atas ou manuais sem ter de manter uma equipa de desenvolvimento.
- O RAG (Retrieval Augmented Generation) liga um modelo de linguagem a uma base de conhecimento própria, de modo que o agente aceda aos seus documentos e não apenas ao que aprendeu no treino.
- O n8n encarrega-se da automatização; o Supabase serve ao mesmo tempo de memória de conversa e de base de dados vetorial.
- Toda a montagem funciona sem programação e, segundo o vídeo, fica pronta em menos de 15 minutos.
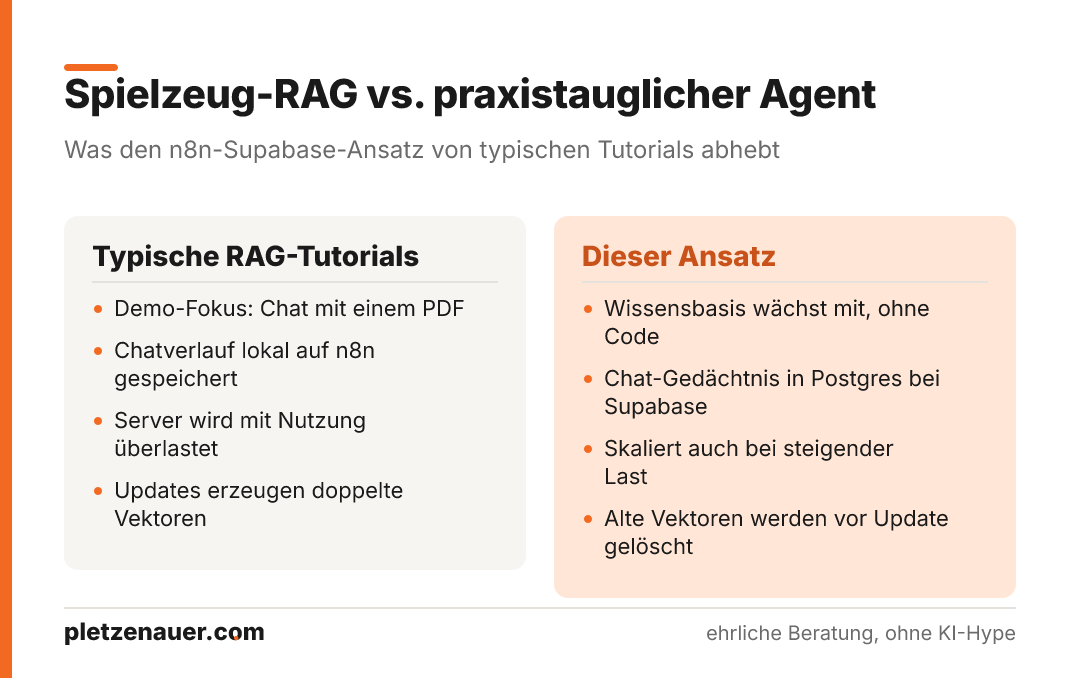
- Dois detalhes distinguem esta abordagem dos tutoriais superficiais: um armazenamento escalável para o histórico da conversa e a eliminação de vetores desatualizados, para evitar duplicados.
- Segundo o vídeo, o escalão gratuito do Supabase chega perfeitamente para começar.
O que o agente faz na prática
O funcionamento é mostrado no vídeo com um exemplo simples. No início a base de conhecimento está vazia e a tabela correspondente no Supabase não tem registos. Como seria de esperar, o agente não consegue responder a uma pergunta de teste sobre as tarefas saídas de uma reunião.
De seguida, coloca-se numa pasta vigiada um documento com notas de reunião, sob a forma de Google Doc. Ao fim de cerca de um minuto corre em segundo plano um fluxo de trabalho n8n que processa o ficheiro e o insere na base de conhecimento. Depois disso surge no Supabase um novo registo com o conteúdo da página, os metadados (entre outros, o ID do ficheiro no Google Drive) e o chamado vetor de embedding. Se voltar a fazer a mesma pergunta, o agente dá agora a resposta correta a partir do documento. As atualizações do ficheiro são igualmente detetadas e refletidas.
A montagem em síntese
O fluxo de trabalho tem duas partes: o agente de conversa propriamente dito e um percurso separado que insere documentos automaticamente na base de conhecimento. Segundo o vídeo, é possível descarregar de um repositório GitHub um template JSON já pronto e carregá-lo na própria instância de n8n através de “Import from file”. Depois disso, basta acrescentar as próprias credenciais e a pasta pretendida.
Preparar o Supabase
O Supabase é configurado com uma conta GitHub. Duas áreas das definições do projeto fornecem as credenciais necessárias:
- Database: host, nome da base de dados, porta, utilizador e palavra-passe para a ligação Postgres. Estes dados são usados para a memória de conversa.
- API: o URL específico do projeto e o service role secret. Estes dados são necessários para a base de dados vetorial.
Para a pesquisa vetorial, o n8n disponibiliza na sua documentação código SQL já pronto. Executa-se uma única vez no editor SQL do Supabase e cria automaticamente a extensão PG Vector, a tabela de documentos e a função de correspondência para RAG. Não é preciso escrever código próprio.
O agente de conversa
O agente é iniciado por um acionador “When a chat message is received”. Este disponibiliza ao mesmo tempo uma janela de conversa dentro do próprio n8n, com a qual se pode testar o agente sem qualquer deployment. Se necessário, a mesma interface pode ser integrada num site através de código de incorporação já pronto. Ao agente estão ligados três blocos:
- Modelo de conversa: no exemplo, GPT-4o mini, ligado através da chave de API da OpenAI. Em alternativa, também é possível usar a Anthropic.
- Memória de conversa: aqui usa-se deliberadamente Postgres através do Supabase, em vez do armazenamento local em janela tantas vezes recomendado. O armazenamento local sobrecarrega o servidor n8n e escala mal. A tabela necessária é criada pelo próprio n8n quando é preciso.
- Ferramenta RAG: a ferramenta “retrieve documents” com o Supabase como armazenamento vetorial, configurada através do nome da tabela e da função de consulta.
Inserir documentos automaticamente
A segunda parte do fluxo de trabalho mantém a base de conhecimento atualizada. Um acionador do Google Drive verifica regularmente numa pasta definida se há ficheiros novos ou alterados. O resto do processo:
- O ID do ficheiro é extraído e passado aos passos seguintes.
- Os vetores existentes com o mesmo ID de ficheiro são eliminados no Supabase (mais sobre isto abaixo).
- O ficheiro é descarregado; os documentos são convertidos em texto e as folhas do Google Sheets em CSV, para obter o conteúdo textual puro.
- O texto é inserido na base de dados vetorial. Em ficheiros pequenos dispensa-se a divisão em blocos; caso contrário, usa-se um simples divisor de texto recursivo.
Dois detalhes que decidem a utilidade na prática
O artigo destaca dois pontos que faltam em muitos tutoriais e que causam problemas precisamente quando a coisa fica séria.
Memória de conversa escalável
O histórico de uma conversa é muitas vezes guardado localmente na instância de n8n, por ser o mais simples. É precisamente isso que sobrecarrega o servidor à medida que a utilização cresce. Passá-lo para uma base de dados Postgres no Supabase é o passo que torna o agente verdadeiramente robusto.
Eliminar vetores desatualizados
O ponto mais importante diz respeito às atualizações. As opções de vetores do n8n não funcionam como “upsert”: ao ser inserido de novo, um vetor existente não é substituído, mas duplicado, porque o ID do ficheiro não serve de ID do vetor. Se atualizar várias vezes o mesmo ficheiro, acumulam-se duplicados e a qualidade das respostas sofre. A solução no fluxo de trabalho: antes de cada inserção são eliminados todos os vetores cujos metadados contêm o ID do ficheiro do documento atual do Google Drive. Só depois é inserida a versão nova e atualizada. Assim mantém-se exatamente um registo atual por documento.
Enquadramento para quem decide
A montagem apresentada é explicitamente pensada como um ponto de partida sólido, não como solução final acabada. Extensões como uma melhor pesquisa semântica ou uma pesquisa adicional por palavras-chave são possíveis, mas ficam deliberadamente em aberto. Ainda assim, para uma primeira base de conhecimento próxima da produção, a abordagem aguenta-se.
Digno de nota é o lado dos custos: segundo o vídeo, o escalão gratuito do Supabase chega para começar, e a mudança para o plano pago só compensa quando se escala. Quem já trabalha com n8n consegue montar o agente com os seus próprios documentos em pouco tempo, sem encomendar desenvolvimento externo.
Conclusão
O artigo mostra de forma sóbria e compreensível como implementar um agente de IA RAG com n8n e Supabase sem programação. O verdadeiro valor não está no efeito rápido de demonstração, mas em dois detalhes muitas vezes ignorados: uma memória de conversa escalável e a remoção consequente de vetores desatualizados. São precisamente estes pontos que decidem se um agente continua utilizável à medida que a base de conhecimento cresce ou se se torna pouco fiável com o tempo. Quem quiser tornar documentos internos pesquisáveis recebe aqui um plano pragmático, que pode ser alargado passo a passo.
Fonte: Cole Medin, “This RAG AI Agent with n8n + Supabase is the Real Deal”, https://www.youtube.com/watch?v=PEI_ePNNfJQ
Newsletter
Praxiswissen per E-Mail.
Neue Artikel und Erfahrungen aus Projekten mit Claude, WordPress und Zoho. Kein Spam, Abmeldung jederzeit.
Fast geschafft.
Bitte bestätigen Sie die Anmeldung über den Link in der Mail, die gerade unterwegs ist.
Vamos falar
Parece-lhe a sua situação?
Conte-me brevemente em que está a trabalhar. Digo-lhe se e como posso ajudar. A conversa é gratuita.