Agentic RAG no n8n: porque o RAG clássico falha muitas vezes – e como fazer melhor
O RAG clássico ignora muitas vezes o contexto e os dados de tabelas. Como uma configuração de Agentic RAG no n8n pesquisa bases de conhecimento de forma mais fiável – explicado de forma prática.
Muitas empresas apostam hoje em assistentes de IA que devem responder a perguntas sobre os seus próprios documentos – atas de reuniões, tabelas de indicadores ou feedback de clientes. O procedimento habitual por trás disso chama-se Retrieval Augmented Generation (RAG). Está difundido, é bem suportado e implementa-se depressa em ferramentas no-code como o n8n. Só que, na prática, o RAG clássico dá respostas erradas ou incompletas com uma frequência surpreendente. Cole Medin mostra no seu vídeo a que se deve isso e como uma configuração de Agentic RAG contorna as fraquezas típicas. Resumo aqui os pontos mais importantes de forma sóbria.
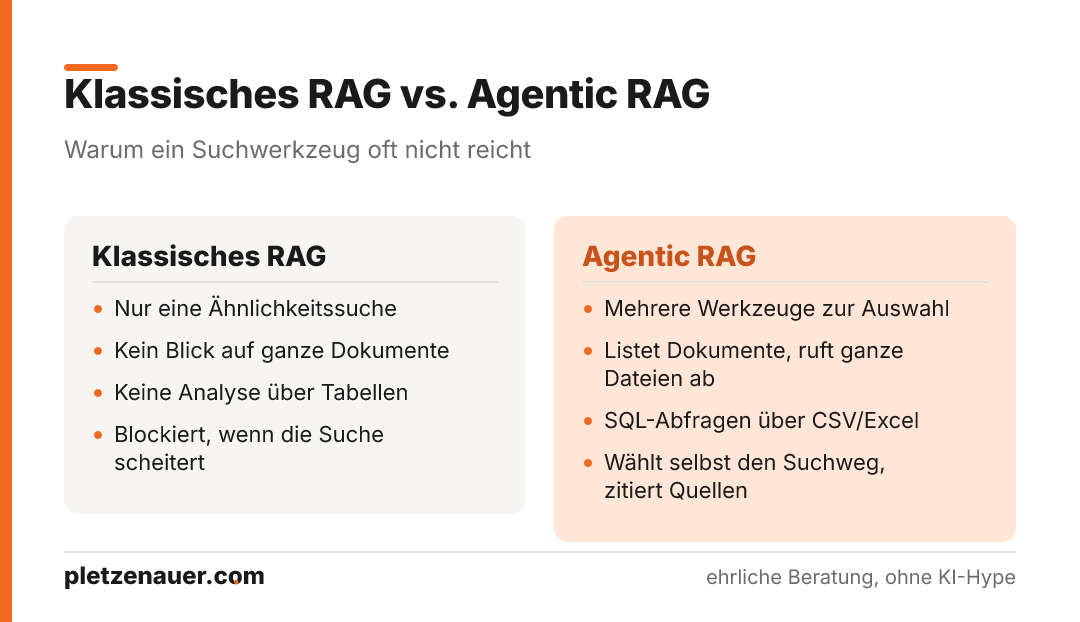
- O RAG clássico falha sobretudo em duas coisas: não consegue «afastar o zoom» para documentos inteiros e não consegue fazer verdadeira análise de dados sobre tabelas.
- O Agentic RAG dá ao agente de IA várias ferramentas em vez de uma única pesquisa – é ele que decide como pesquisa a base de conhecimento.
- As tabelas (CSV/Excel) são guardadas em separado, de forma a poderem ser consultadas por SQL – sem criar uma tabela própria para cada ficheiro.
- O agente consegue listar documentos, obter ficheiros inteiros, citar fontes e, se for preciso, melhorar a pesquisa.
- A configuração de n8n apresentada é um modelo ampliável, não um produto acabado – os prompts e as ferramentas têm de ser adaptados ao caso de uso concreto.
Porque o RAG clássico desilude na prática
O RAG funciona por pesquisa de semelhança: a pergunta é comparada com pedaços de texto guardados («chunks») e os mais adequados são passados ao modelo de linguagem. O problema está na seleção. Ela ignora com regularidade contexto importante.
Medin aponta duas fragilidades concretas:
- Nenhuma visão sobre documentos inteiros: o RAG recorre apenas a excertos isolados. Quem quiser analisar tendências numa tabela talvez receba só um quarto das linhas – e, com isso, um resultado errado.
- Nenhuma análise de dados a sério: somas ou valores máximos ao longo de uma tabela não se calculam de forma fiável com uma pesquisa puramente textual.
A isto junta-se um aborrecimento prático: se se perguntar pela ata de uma determinada data, o RAG vai por vezes buscar o documento do dia errado – embora a data esteja no título. E ligar documentos diferentes entre si, para estabelecer um contexto mais amplo, raramente resulta.
O que o Agentic RAG faz de diferente
A ideia central é simples: em vez de dar ao agente de IA uma única ferramenta de pesquisa, dão-se-lhe várias – e deixa-se que ele próprio decida como aborda a base de conhecimento. Medin define assim o Agentic RAG:
Agentic RAG significa dar ao agente a capacidade de refletir sobre como pesquisa a base de conhecimento – em vez de o prender a uma única ferramenta.
Em concreto, isso permite-lhe melhorar as suas consultas, escolher outra ferramenta quando for preciso e experimentar vários caminhos até ter uma resposta sólida. Se a pesquisa RAG pura falhar, ele deixa de ficar bloqueado.
As quatro ferramentas do agente
No fluxo de trabalho n8n o agente dispõe das seguintes ferramentas:
- Pesquisa RAG – a clássica pesquisa de semelhança, na versão melhorada já com indicação da fonte.
- Listar documentos – o agente obtém todos os documentos com títulos e IDs e pondera quais poderão ser relevantes.
- Obter o conteúdo de um ficheiro – através do ID do ficheiro vai buscar o texto completo de um documento específico (por exemplo, a ata de 23 de fevereiro, identificável pelo título).
- Consulta SQL sobre tabelas – os ficheiros CSV e Excel são consultados como tabelas SQL, para tornar possíveis somas, máximos e análises semelhantes.
No prompt de sistema, o agente é instruído a começar pelo RAG e a recorrer às restantes ferramentas apenas quando a pesquisa não devolver o que é preciso. Uma indicação importante do vídeo: pedir explicitamente honestidade ao agente – ou seja, que diga abertamente quando não encontrou resposta – reduz de forma sensível as alucinações.
Como são guardados os dados de tabelas
A parte tecnicamente mais interessante diz respeito às tabelas. Para isso são criadas no Supabase três tabelas:
- documents – contém os embeddings para o RAG, os metadados e os conteúdos de cada chunk.
- document_metadata – guarda informação de nível superior: títulos, URLs para indicação de fontes e – no caso das tabelas – o esquema (ou seja, os nomes das colunas).
- document_rows – armazena as linhas das tabelas. Os dados propriamente ditos vão para uma coluna JSONB flexível chamada
row_data.
O truque: com JSONB é possível guardar quaisquer estruturas de colunas, sem ter de criar uma tabela SQL própria para cada ficheiro CSV ou Excel. O agente lê primeiro o esquema a partir dos metadados, percebe que colunas estão disponíveis e formula depois uma consulta SQL contra row_data. Medin sublinha expressamente que esta configuração é simplificada – o esquema nada diz, por exemplo, sobre tipos de dados, pelo que uma soma sobre uma coluna com cifrões pode falhar. O que lhe interessa é o conceito, não uma implementação perfeita.
O pipeline de RAG: do Google Drive para o Supabase
Antes de o agente poder trabalhar, é preciso encher a base de conhecimento. O pipeline decorre em vários passos:
- Acionador: um acionador do Google Drive verifica a cada minuto se há ficheiros novos ou alterados. Em alternativa funcionam o Dropbox ou um acionador de ficheiros local. Os ficheiros eliminados, porém, não são detetados.
- Vários ficheiros ao mesmo tempo: um ciclo recém-acrescentado processa agora também vários ficheiros que chegam no mesmo intervalo de polling – uma falha conhecida da versão anterior.
- Eliminar dados antigos: antes de cada importação são removidos os registos existentes para o respetivo ID de ficheiro. Assim não fica para trás nenhum chunk desatualizado quando um documento ficou mais curto.
- Extrair o conteúdo: um nó Switch ramifica consoante o tipo de ficheiro – PDF, Google Doc, texto ou tabela são lidos de maneiras diferentes. Outros formatos, como JSON ou HTML, podem ser acrescentados através de nós adicionais.
- Guardar as tabelas em duplicado: os ficheiros CSV são, por um lado, preparados como documento de texto para o RAG e, por outro, guardados linha a linha em
document_rowspara consultas SQL.
Um obstáculo prático na configuração: segundo o vídeo, para a ligação Postgres ao Supabase tem de se usar o transaction pooler (porta 6543) e não a ligação direta. A documentação do n8n seria pouco clara neste ponto.
Modelos utilizados
Para os embeddings é usado o text-embedding-3 da OpenAI e, como modelo de linguagem, o GPT-4o mini – escolhidos deliberadamente por serem baratos e rápidos. Para casos mais exigentes, Medin recomenda modelos mais potentes, como o GPT-4o ou o Claude Sonnet 4. Importante: na inserção e na consulta tem de se usar o mesmo modelo de embedding, com o mesmo número de dimensões.
Três exemplos do vídeo
Medin demonstra como o agente escolhe ferramentas diferentes consoante a pergunta:
- Pergunta sobre tabelas: perante «em que mês tivemos mais clientes novos?», o agente escreve uma consulta SQL e devolve o resultado correto (dezembro, 129 clientes novos) – em vez de confiar em chunks incompletos.
- Pergunta puramente de RAG: perante «onde podemos melhorar?», a pesquisa de semelhança encontra o documento de feedback, apesar de a palavra «melhoria» não ter sido usada de propósito.
- Obtenção de ficheiro com fonte: ao obter uma ata de reunião completa, o agente devolve os action items e, se lhe for pedido, uma ligação clicável para a fonte.
Conclusão
O artigo mostra de forma sóbria porque o RAG ingénuo não chega para muitas aplicações de negócio: ignora contexto e não sabe calcular com tabelas. A abordagem agentic resolve isso de forma pragmática, dando ao agente de IA várias ferramentas e margem de decisão. Para quem decide numa PME e pondera um assistente de documentos, esta é uma conclusão importante: a qualidade não depende apenas do modelo, mas da arquitetura por trás dele. Quem adotar a configuração de n8n apresentada deve entendê-la como ponto de partida – os prompts, as ferramentas e o modelo de dados têm de ser adaptados ao próprio acervo de dados. Precisamente a consulta SQL sobre tabelas e o tratamento dos tipos de dados deixam espaço para melhorias.
Fonte: Cole Medin – „I Built the ULTIMATE n8n RAG AI Agent Template”, https://www.youtube.com/watch?v=mQt1hOjBH9o
Newsletter
Praxiswissen per E-Mail.
Neue Artikel und Erfahrungen aus Projekten mit Claude, WordPress und Zoho. Kein Spam, Abmeldung jederzeit.
Fast geschafft.
Bitte bestätigen Sie die Anmeldung über den Link in der Mail, die gerade unterwegs ist.
Vamos falar
Parece-lhe a sua situação?
Conte-me brevemente em que está a trabalhar. Digo-lhe se e como posso ajudar. A conversa é gratuita.